開発のきっかけ
もともとは自分用のツールとして始めました。日本語を勉強していて(N4からN3を目指しているところです)、自分の学び方に合った復習方法が欲しかったのです。作っていくうちに、日本語や中国語を学ぶスペイン語話者向けのプロダクトには余地があると感じ、ほかの人にも使ってもらえるように作り込みました。
仕組み
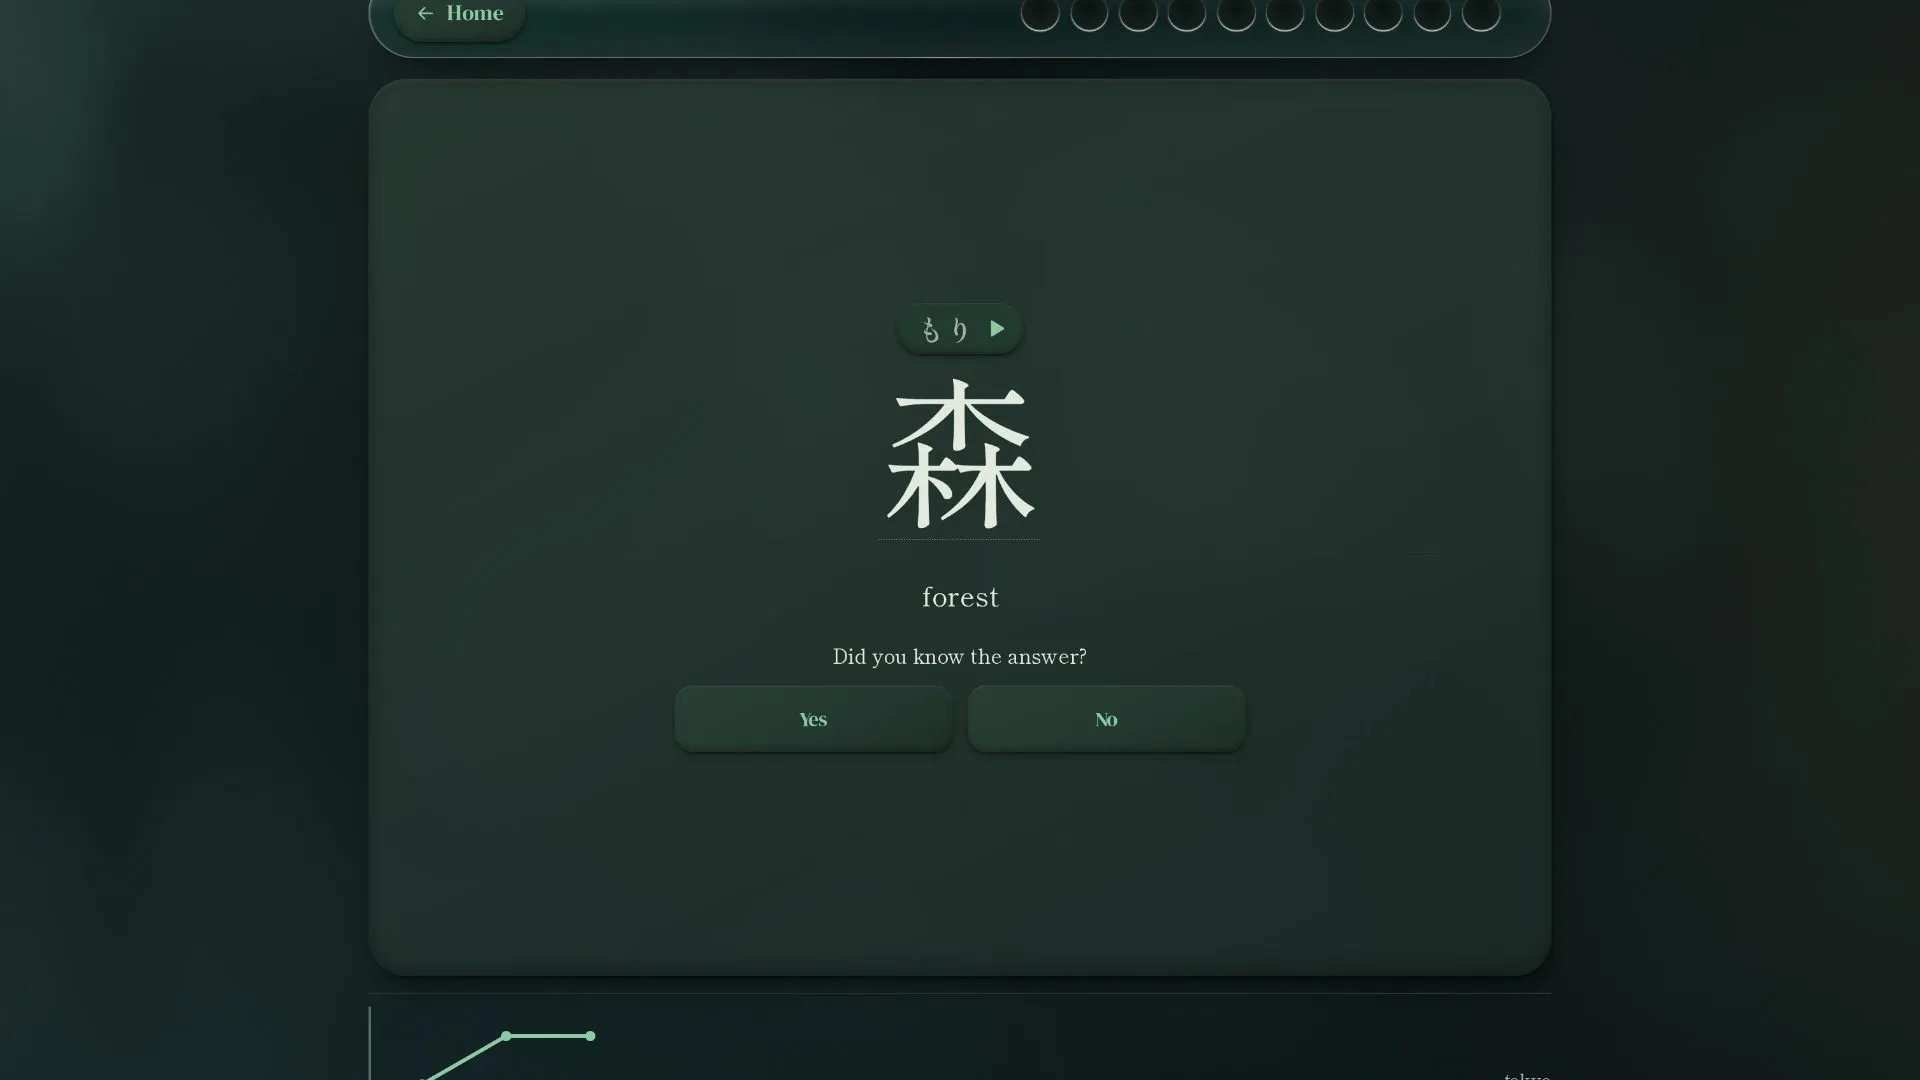
単語や漢字は、意味の認識、読み、一画ずつの書き取り、ピッチアクセントという別々のスキルとして学習します。復習のスケジュールはFSRSで管理しています。FSRSは、学習者が内容を忘れそうになるタイミングを推定し、その直前に出題する間隔反復(spaced repetition)アルゴリズムです。
デッキはJLPTのレベル、学年、使用頻度ごとに構成し、中国語はHSK 3.0のレベル別に用意しています。音声はすべて事前収録で、日本語が約17,400件、中国語が約11,000件あります。
技術的な判断
- スキルごとの進捗管理。 漢字の書き取りを間違えても、その漢字を認識する力として身についていた分はリセットされません。
- 出典を確認したデータ。 コンテンツはオープンな辞書(JMdict、KANJIDIC2、KanjiVG、CC-CEDICTなど)から取得しており、それぞれのライセンスを確認しました。データが存在しない場合は、作り上げるのではなく「なし」と表示します。
- 中国語はオプションのレイヤーとして扱い、並行するコースにはしていません。日本語 | 中文 の切り替え、専用の辞書、文字の上に表示するピンイン、声調に合わせた音声を備えています。
- 決済はPaddle。 Stripeはペルー拠点の事業者を受け付けていないため、有料プランではPaddleをMerchant of Record(販売代行事業者)として利用しています。
- TypeScriptのモノレポ(React + NestJS + PostgreSQL)で、約190のユニットテストファイルとPlaywrightによるE2Eテストがあります。
進捗状況
現在、新規登録は受け付けていません。一般公開に向けて、サーバーの負荷テストと有料プランの準備を進めています。