Por qué lo hice
Empezó como una herramienta para mí: estudio japonés (voy de N4 hacia N3) y quería una forma de repasar que se ajustara a cómo estudio. En el camino vi que había espacio para un producto pensado para hispanohablantes que aprenden japonés o chino, así que lo construí para que otros también puedan usarlo.
Cómo funciona
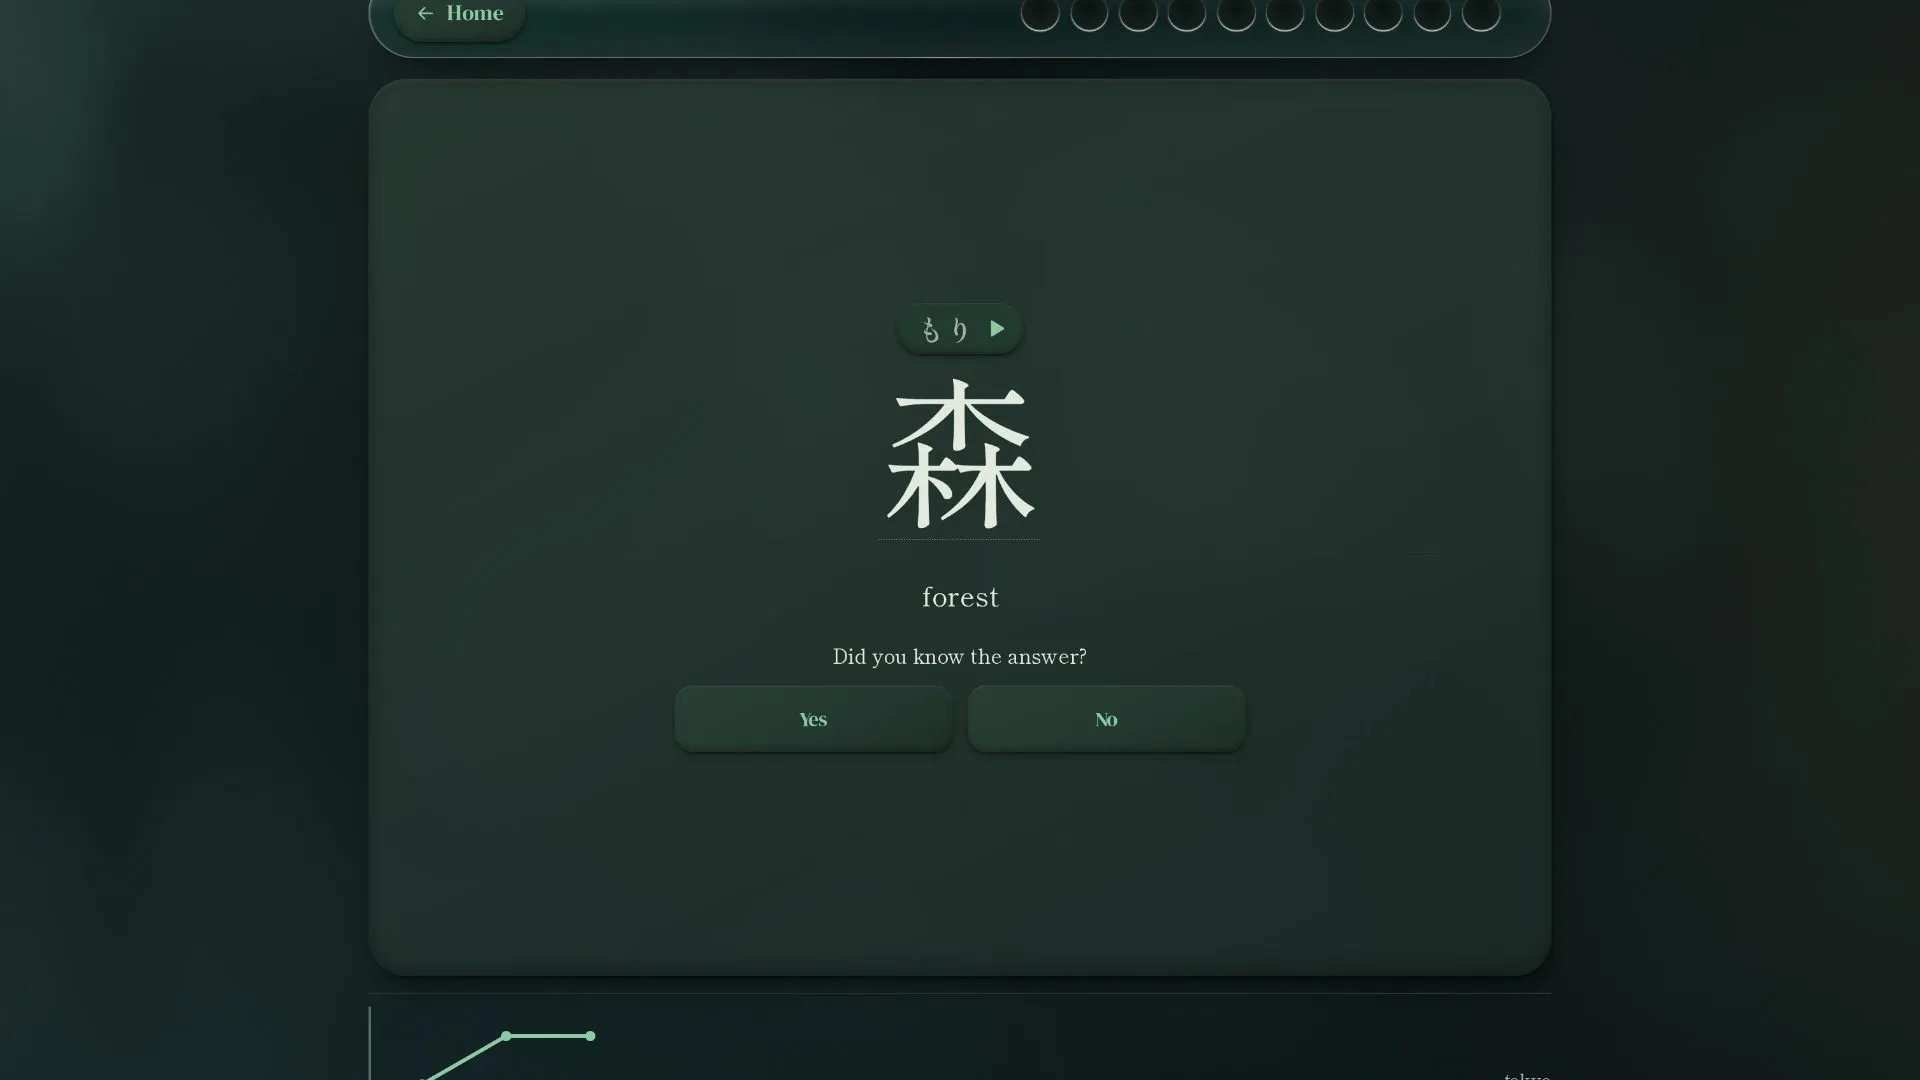
Cada palabra o kanji se estudia en varias habilidades por separado: reconocer el significado, leerlo, escribirlo trazo por trazo y su acento tonal. El repaso se programa con FSRS, un algoritmo de repetición espaciada que calcula cuándo vas a olvidar algo y te lo muestra justo antes.
Los mazos se arman por nivel JLPT, grado escolar o frecuencia de uso, y en chino por niveles HSK 3.0. Todo el audio está pregrabado: unos 17 400 clips en japonés y 11 000 en chino.
Decisiones técnicas
- Progreso por habilidad. Si fallas al escribir un kanji, no se reinicia lo que ya sabías para reconocerlo.
- Datos con origen verificado. El contenido sale de diccionarios abiertos (JMdict, KANJIDIC2, KanjiVG, CC-CEDICT, entre otros) y revisé la licencia de cada uno. Si un dato no existe, la app lo muestra como ausente en vez de inventarlo.
- El chino como capa opcional, no como un curso paralelo: un selector 日本語 | 中文, diccionario propio, pinyin sobre los caracteres y audio según el tono.
- Pagos con Paddle. Stripe no acepta comercios con sede en Perú, así que el plan de pago usa Paddle como revendedor oficial.
- Monorepo en TypeScript (React + NestJS + PostgreSQL), con cerca de 190 archivos de pruebas unitarias y pruebas de extremo a extremo con Playwright.
Estado
Registro cerrado por ahora: estoy probando el rendimiento del servidor y preparando un plan de pago antes de abrirlo al público.